Есть одна деталь, которая сразу бросается в глаза: на главной странице проекта написано «125B+ на 12 ГБ видеопамяти». 125 миллиардов параметров в 12 гигабайтах видеопамяти — это неправдоподобно, если не знать, что это MoE-модель. Реально Strata решает другую задачу: берёт 24 576 маленьких экспертов и раскладывает их по трём уровням памяти — видеокарта, оперативка, SSD.
Проект Niko1221/Strata — это локальный движок инференса на C++/CUDA/Metal, который позволяет запускать большие MoE-модели на потребительском железе. Проект активно развивается: репозиторий создан 24 сентября 2026 года, а последний релиз v0.2.9 вышел 31 октября — то есть Less than two months назад, и за это время набралось 38 276 звёзд, 4 168 форков и 3 821 коммит от автора плюс ещё восемь контрибьюторов.
Разберём, что именно внутри, почему оно работает и что получается на реальном железе.
Зачем нужен ещё один локальный LLM-движок
Локальный инференс сегодня решается в основном llama.cpp и vLLM. Оба инструмента хороши, но у них есть системное ограничение: веса модели должны поместиться в память, и чем крупнее модель, тем больше нужно RAM и VRAM. Для MoE-архитектур вроде Qwen3-235B-A22B или DeepSeek-V3 это означает сотни гигабайт.
Strata идёт от противного. Он не пытается «впихнуть» всю модель в память — он вычисляет экспертов на месте, подгружая их с SSD по мере необходимости. Проект построен поверх ggml/llama.cpp, но переработаны сам планировщик вычислений, формат хранения весов, маршрутизация и работа с памятью. По словам авторов, вдохновением служили Splash, ninfer и HyperQwen.
Задача Strata — не «запустить модель на любом железе», а «запустить серверную MoE-модель на домашнем компьютере без аренды GPU-сервера». Ключевая ставка сделана на разреженность: активируются не все эксперты, а малая часть на каждом токене.
Как устроена трёхуровневая память
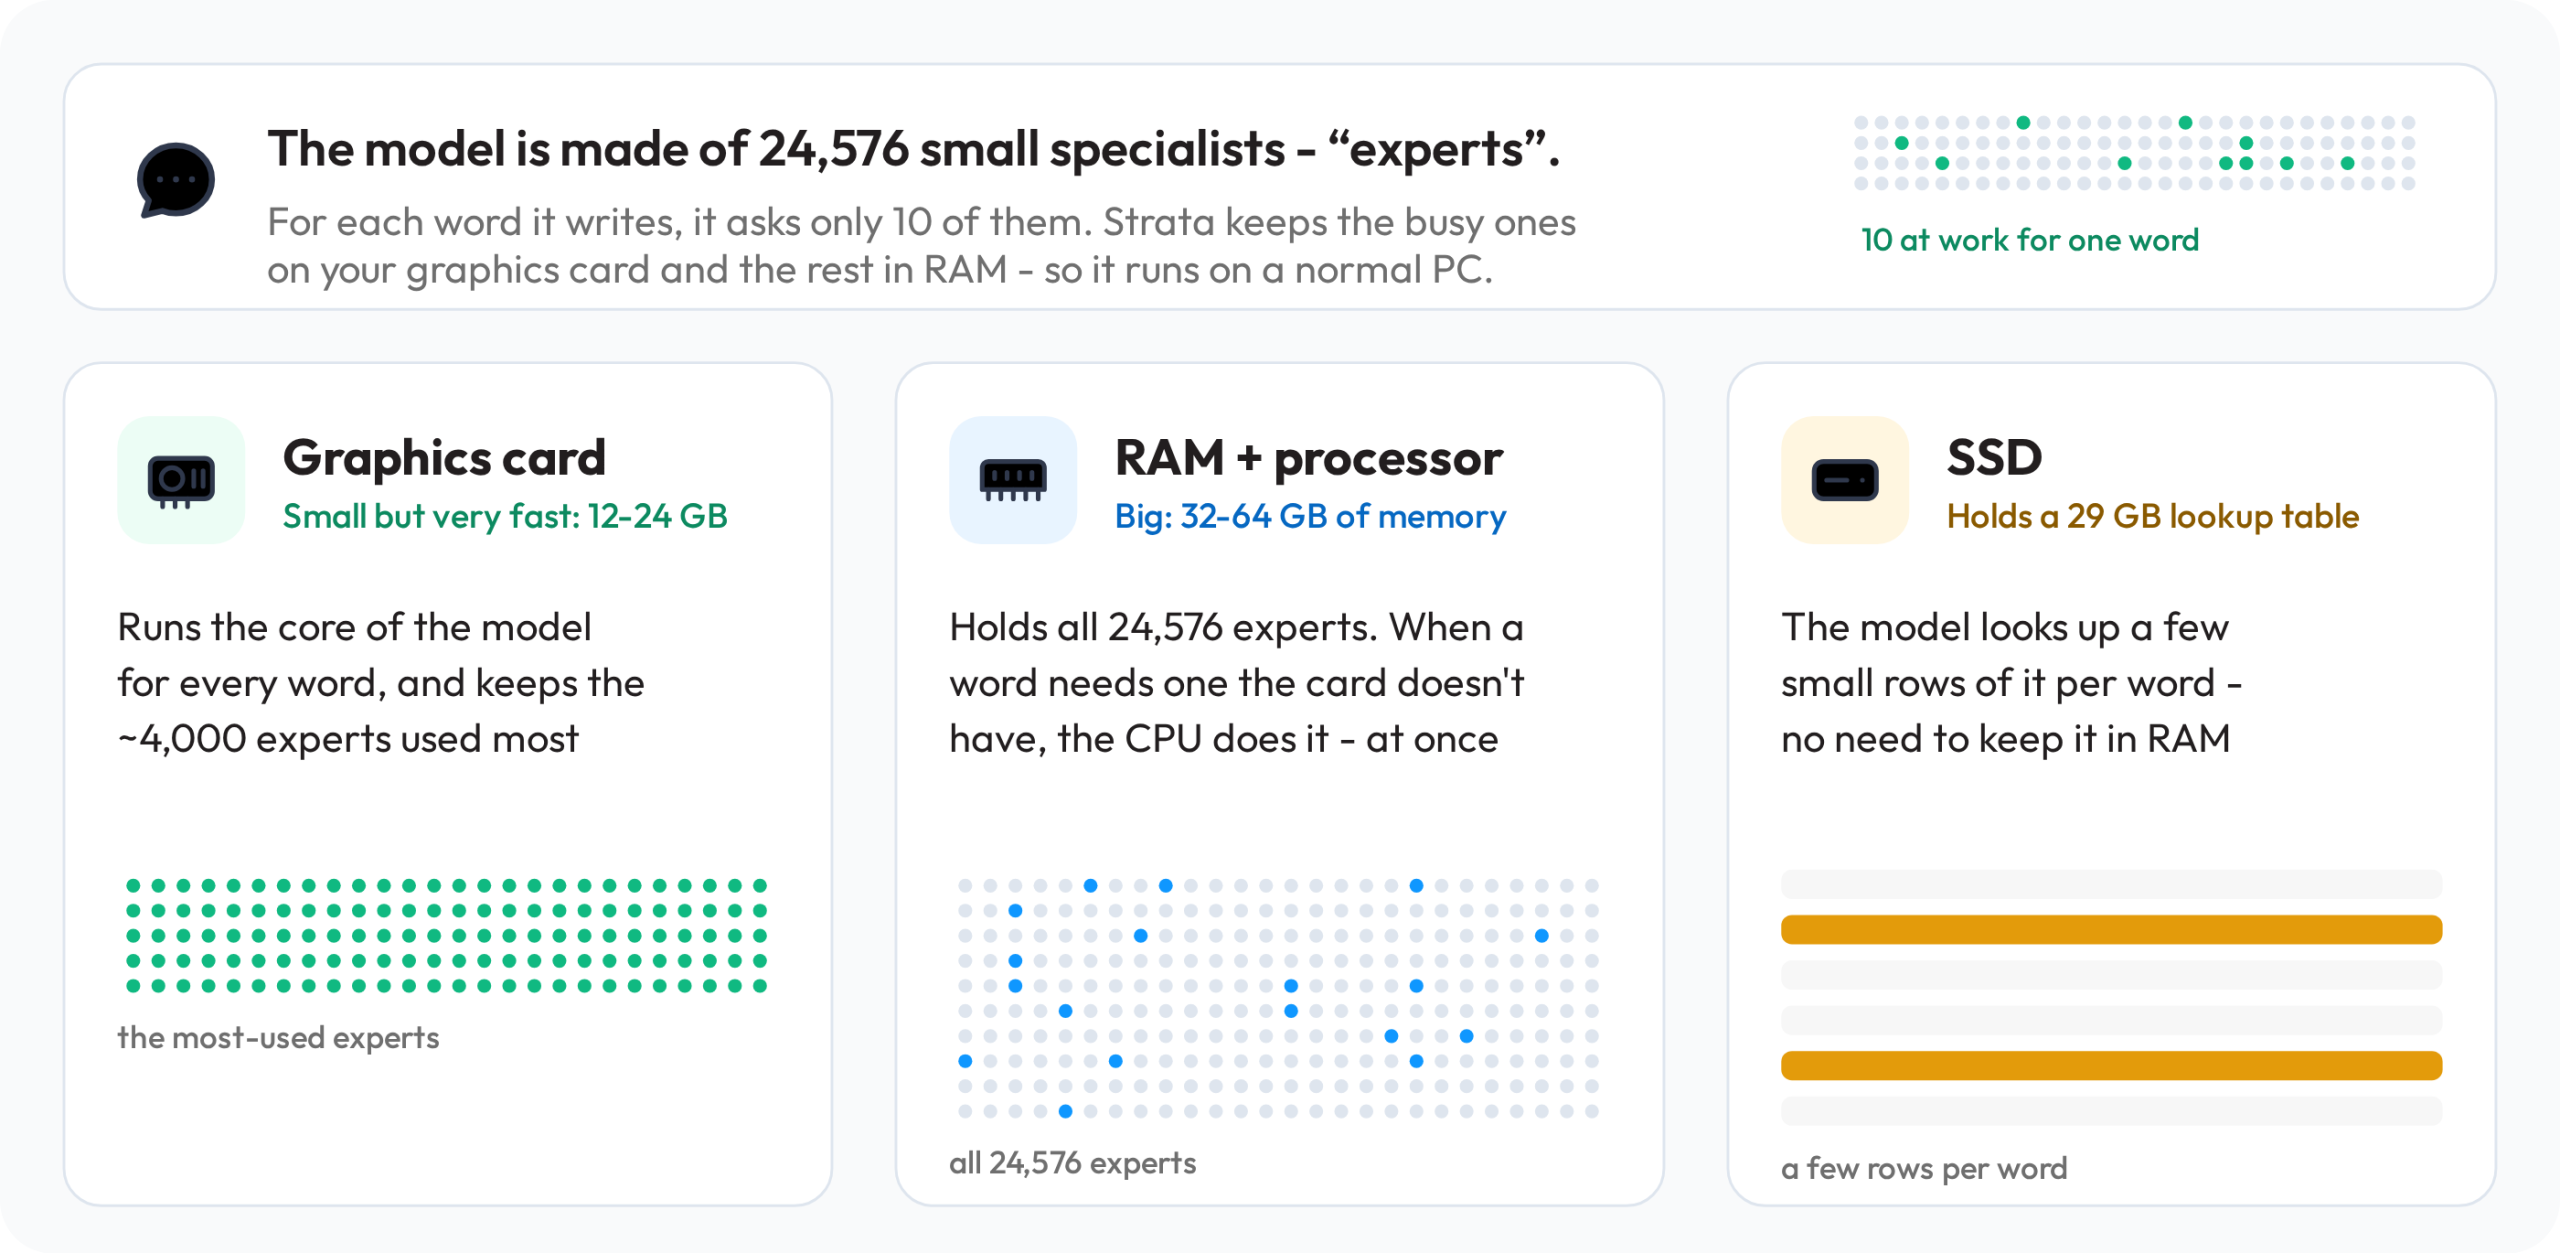
Вся идея умещается в одну схему. У Strata есть три уровня хранения весов, и модель переливает между ними данные по мере генерации.
Уровень 1. GPU: ядро и «горячие» эксперты
На видеокарте живут самые часто используемые эксперты — примерно 4 000 самых «популярных». Правило простое: на каждый дополнительный гигабайт VRAM в кэш помещается около 700 экспертов. Поэтому 12 ГБ видеопамяти хватает, чтобы держать под рукой несколько тысяч самых востребованных.
Уровень 2. RAM и CPU: все 24 576 экспертов целиком
В оперативной памяти resides вся модель — сорок с лишним гигабайт весов при 2-битном квантовании. Когда для очередного токена нужен эксперт, которого нет в VRAM, вычисление уходит на CPU и считается прямо в RAM, на месте, с использованием SIMD-инструкций AVX-512 или AVX2. Никакой перезагрузки — эксперт просто считается в оперативке, пока GPU ждёт.
Уровень 3. SSD: таблица поиска вместо полной модели
На диске лежит не модель, а компактная n-gram таблица поиска объёмом около 28,8 ГБ. По ней движок понимает, какие куски весов нужны дальше, и читает с накопителя лишь несколько строк на слово. Это то, что позволяет запускать настолько большие модели без загрузки их целиком в память.
Дополнительно используется zero-copy pinned memory — память CPU мапится в адресное пространство CUDA напрямую, без промежуточного копирования в буфер. На практике это убирает заметную часть задержек при переключении между уровнями.
«Угадать и проверить» — как ускоряется генерация
Вторая ключевая оптимизация — спекулятивное декодирование. Идея в том, чтобы тратить вычисления не на каждый токен по отдельности, а пачками.
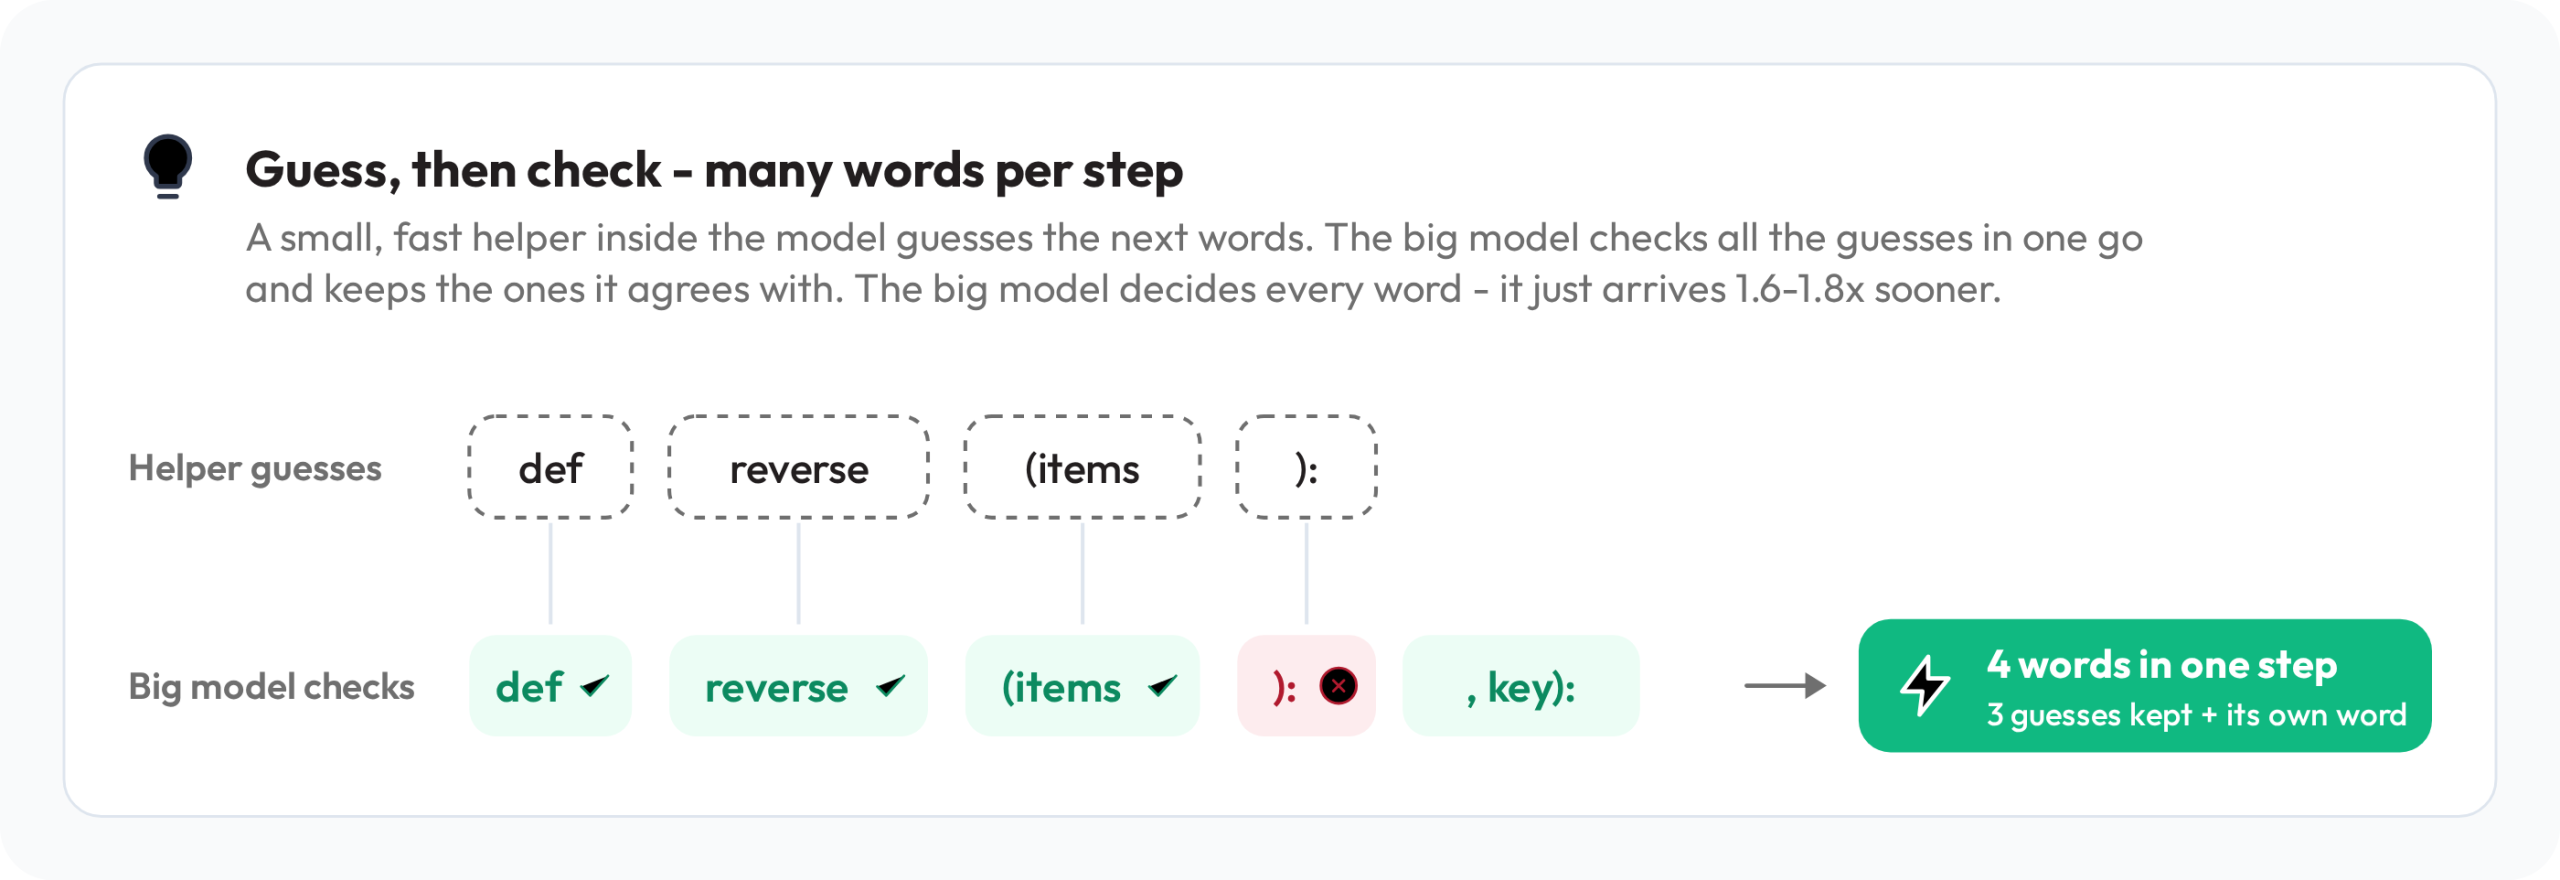
MTP-слой (multi-token prediction) черновит до трёх токенов вперёд, после чего основная модель проверяет весь черновик за один проход. Реализация даёт 2,4–3,2 токена за проход и ускорение примерно в 1,6–1,8 раза. Отдельно реализован prompt lookup: движок находит в уже сгенерированном тексте подходящий фрагмент и переиспользует его, выигрывая до пяти токенов за раз. На реальных задачах правки кода ускоряются на 6–11 %.
Результаты: что показали замеры
Основной бенчмарк репозитория сделан на связке RTX 5070 12 ГБ + Ryzen 5 7600 + 64 ГБ DDR5 (Windows, engine 0.1.26) на модели Qwen3.8-Flash-Next 125B. Это, пожалуй, самый показательный тест — ровно та конфигурация, ради которой проект и делается.
Скорость генерации (tok/s)
| Квантование | 1K | 4K | 32K | 64K | 128K | 262K |
|---|---|---|---|---|---|---|
| Q2_0 | 87,3 | 93,0 | 81,8 | 76,2 | 73,7 | 60,3 |
| IQ2_XS | 79,6 | 78,6 | 76,3 | 63,7 | 62,7 | 52,8 |
| IQ3_XXS | 61,9 | 61,6 | 58,5 | 57,2 | 49,0 | — |
| IQ3_S | 52,4 | 53,3 | 48,3 | 46,3 | 45,5 | — |
| Coder | 58,9 | 55,1 | 54,9 | 53,2 | 43,0 | 42,8 |
Здесь 1K–262K — длина контекста. Обратите внимание на форму: скорость почти не проседает до 128K токенов и лишь затем плавно снижается. Для сравнения, официальный монитор Strata на той же RTX 5070 с Gyro-S 32K показывает 45,1 tok/s.
Скорость обработки промпта (tok/s)
| Квантование | 1K | 4K | 32K | 64K | 128K | 262K |
|---|---|---|---|---|---|---|
| Q2_0 | 536 | 1 299 | 2 171 | 2 126 | 2 107 | 1 304 |
Промпт на 32K токенов прожевывается со скоростью свыше 2 100 токенов в секунду. Время до первого токена (TTFT) при этом составляет около 4 секунд на 4K, 25 секунд на 32K, меньше двух минут на 128K и примерно 4,5 минуты на 262K. Длинные тексты читаются чанками до 8 192 токенов, при этом throughput на чтении держится выше 1 000 токенов в секунду.
Что показывает монитор
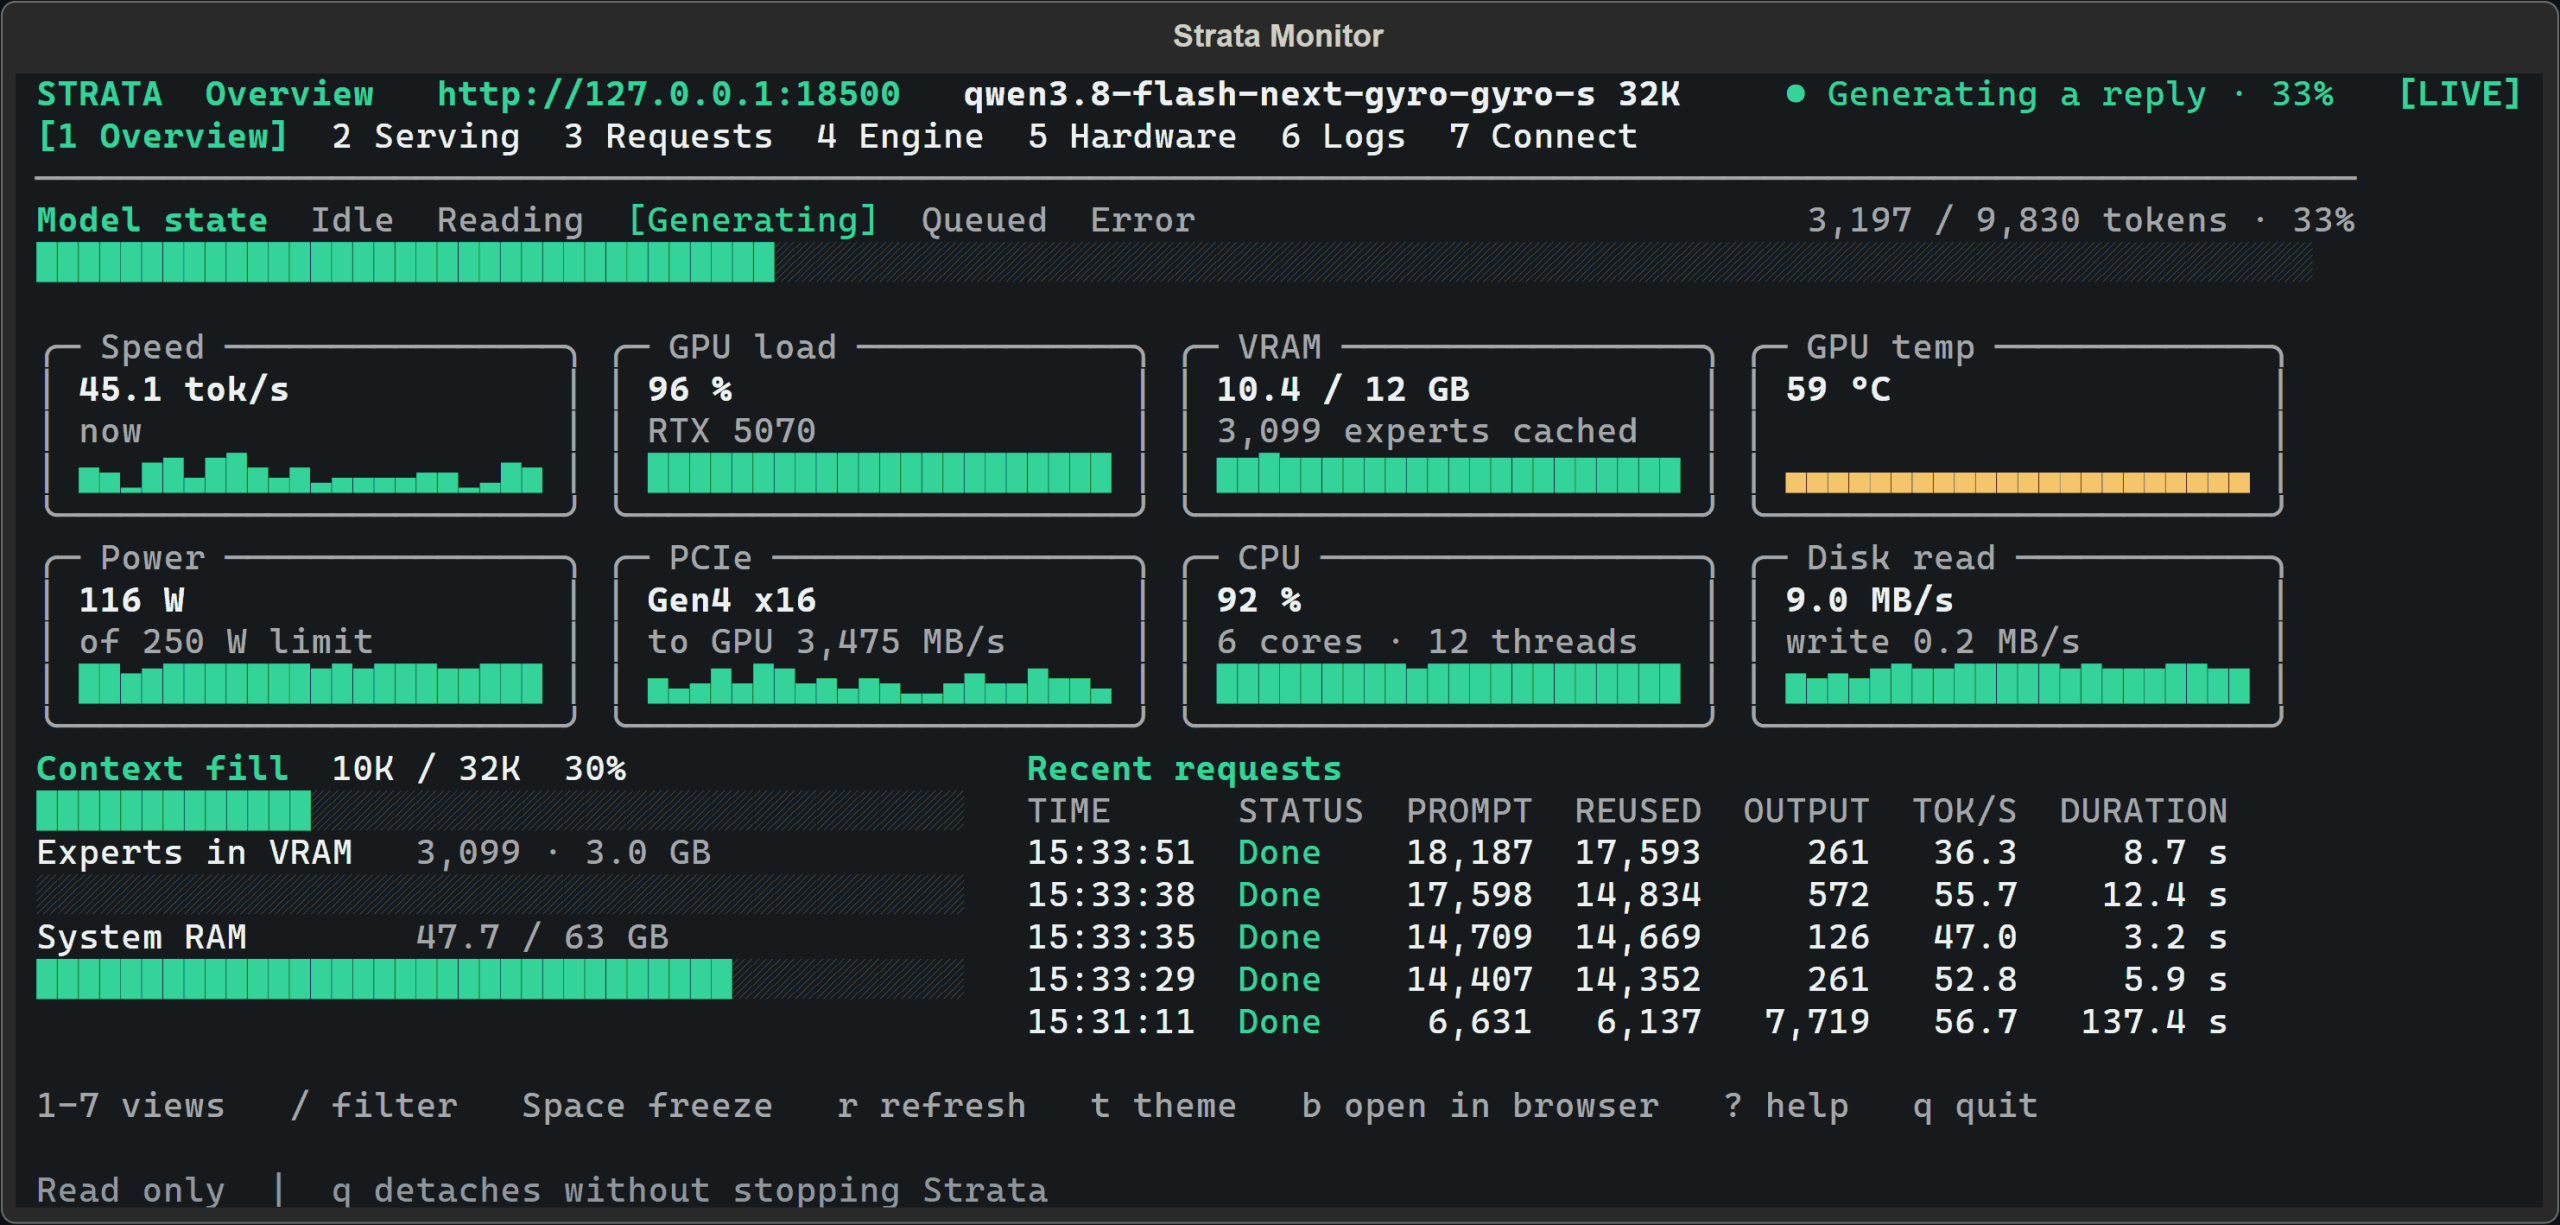
Встроенный монитор показывает не только токены в секунду, но и состояние кэша экспертов, загрузку VRAM и RAM. Для пользователя это важно: видно, что именно сейчас происходит с памятью и хватает ли кэша.
Качество против размера
Выбор квантования — это всегда компромисс между скоростью и качеством. Strata даёт четыре основных варианта для Qwen3.8-Flash-Next 125B:
- Q2_0 — 37,6 ГБ. Самый быстрый вариант, качество приемлемое.
- IQ2_XS — 39,2 ГБ. Чуть медленнее, но качественно лучше.
- IQ3_XXS — 47,0 ГБ. Заметно медленнее, качество «отличное».
- IQ3_S — 54,8 ГБ. Самый медленный и самый большой, но на опубликованных тестах вывод совпадает с полной моделью.
- Coder — около 32 ГБ. Специализированная сборка, активируется только половина экспертов.
Также доступны квантования Unsloth на 4–8 бит (72–136 ГБ) — для машин с большим объёмом памяти.
Результаты сообщества
Помимо стенда автора, в репозитории есть отдельный документ с бенчмарками от пользователей — это ценнее любого маркетинга, потому что цифры снимают на живых конфигурациях.
| Конфигурация | Decode (tok/s) | Prompt (tok/s) | Контекст |
|---|---|---|---|
| 2× TITAN RTX 24 ГБ + 125 ГБ RAM | 70,9–77,3 | 868–1 626 | 262 144 |
| RTX 5070 12 ГБ + 64 ГБ RAM | до 93,0 | до 2 171 | до 262 144 |
Отдельные любопытные результаты:
- На конфигурации с двумя TITAN RTX тест «игол в стоге сена» (needles) пройден полностью — 6 из 6 — на контексте 32K и 128K. Это проверка на то, что модель реально «читает» длинный контекст, а не имитирует.
- На V100 (sm_70) опциональные Volta-ядра дают +9,8 % / +15,0 % к скорости decode, при этом вывод остаётся бит-в-бит идентичным — то есть ускорение не меняет результат.
- На ноутбуке HP ZBook Ultra G1a с Ryzen AI Max+ 395 (Strix Halo, 128 ГБ unified memory, 70 Вт) получено 19–21 tok/s на коде и 11 tok/s на чате.
- Radeon 8060S и Ryzen AI Max+ 395 в ноутбуке работают через unified memory.
DeepSeek V4.1-Flash
Вторая крупная модель в списке — DeepSeek V4.1-Flash, и цифры по ней наглядно показывают, что при 1,75–2,25 bpw весит она от 239 до 274 ГБ. Дальше результаты уже зависят от объёма памяти по-настоящему:
| Железо | Скорость |
|---|---|
| RTX 5070 12 ГБ + 64 ГБ RAM | 4–6 tok/s |
| RTX 3060 12 ГБ + 46 ГБ RAM | 9–11 tok/s |
| 1× R9700 + 251 ГБ RAM | 21–25 tok/s |
| 4× R9700 | 74–77 tok/s |
Здесь картина уже «классическая»: без нормального объёма памяти модель формально запускается, но говорить с ней комфортно не получается. Маркетинговые 25–38 tok/s с сайта stratallm.org относятся именно к конфигурациям с большим объёмом RAM, а не к голой видеокарте.
Поддерживаемое железо
Strata работает не только на NVIDIA. Поддержка выглядит так:
- NVIDIA: RTX 20-й, 30-й, 40-й и 50-й серий; DGX Spark (Linux).
- AMD: Radeon RX 7700 / 7800 / 7900, RX 9060 / 9070, AI PRO R9700; RX 6800/6900 — в экспериментальном режиме; Ryzen AI Max (Strix Halo).
- Intel: Arc — только на Linux.
- Apple: Silicon M1 и новее, через Metal-бэкенд.
При этом проект активно использует уникальные для разных вендоров возможности: CUDA-ядра на NVIDIA, ROCm/HIP на AMD, Metal на Mac. Некоторые оптимизации включаются опционально и дают заметный прирост — как те самые +9,8 % на V100.
API и интеграции
Это, пожалуй, самая недооценённая часть проекта. Strata поднимает локальный сервер с OpenAI-совместимым и Anthropic-совместимым API, а значит, к нему подключается практически что угодно:
- Агентные инструменты: Claude Code, Codex CLI, OpenCode, oh-my-pi, Hermes Agent, OpenClaw.
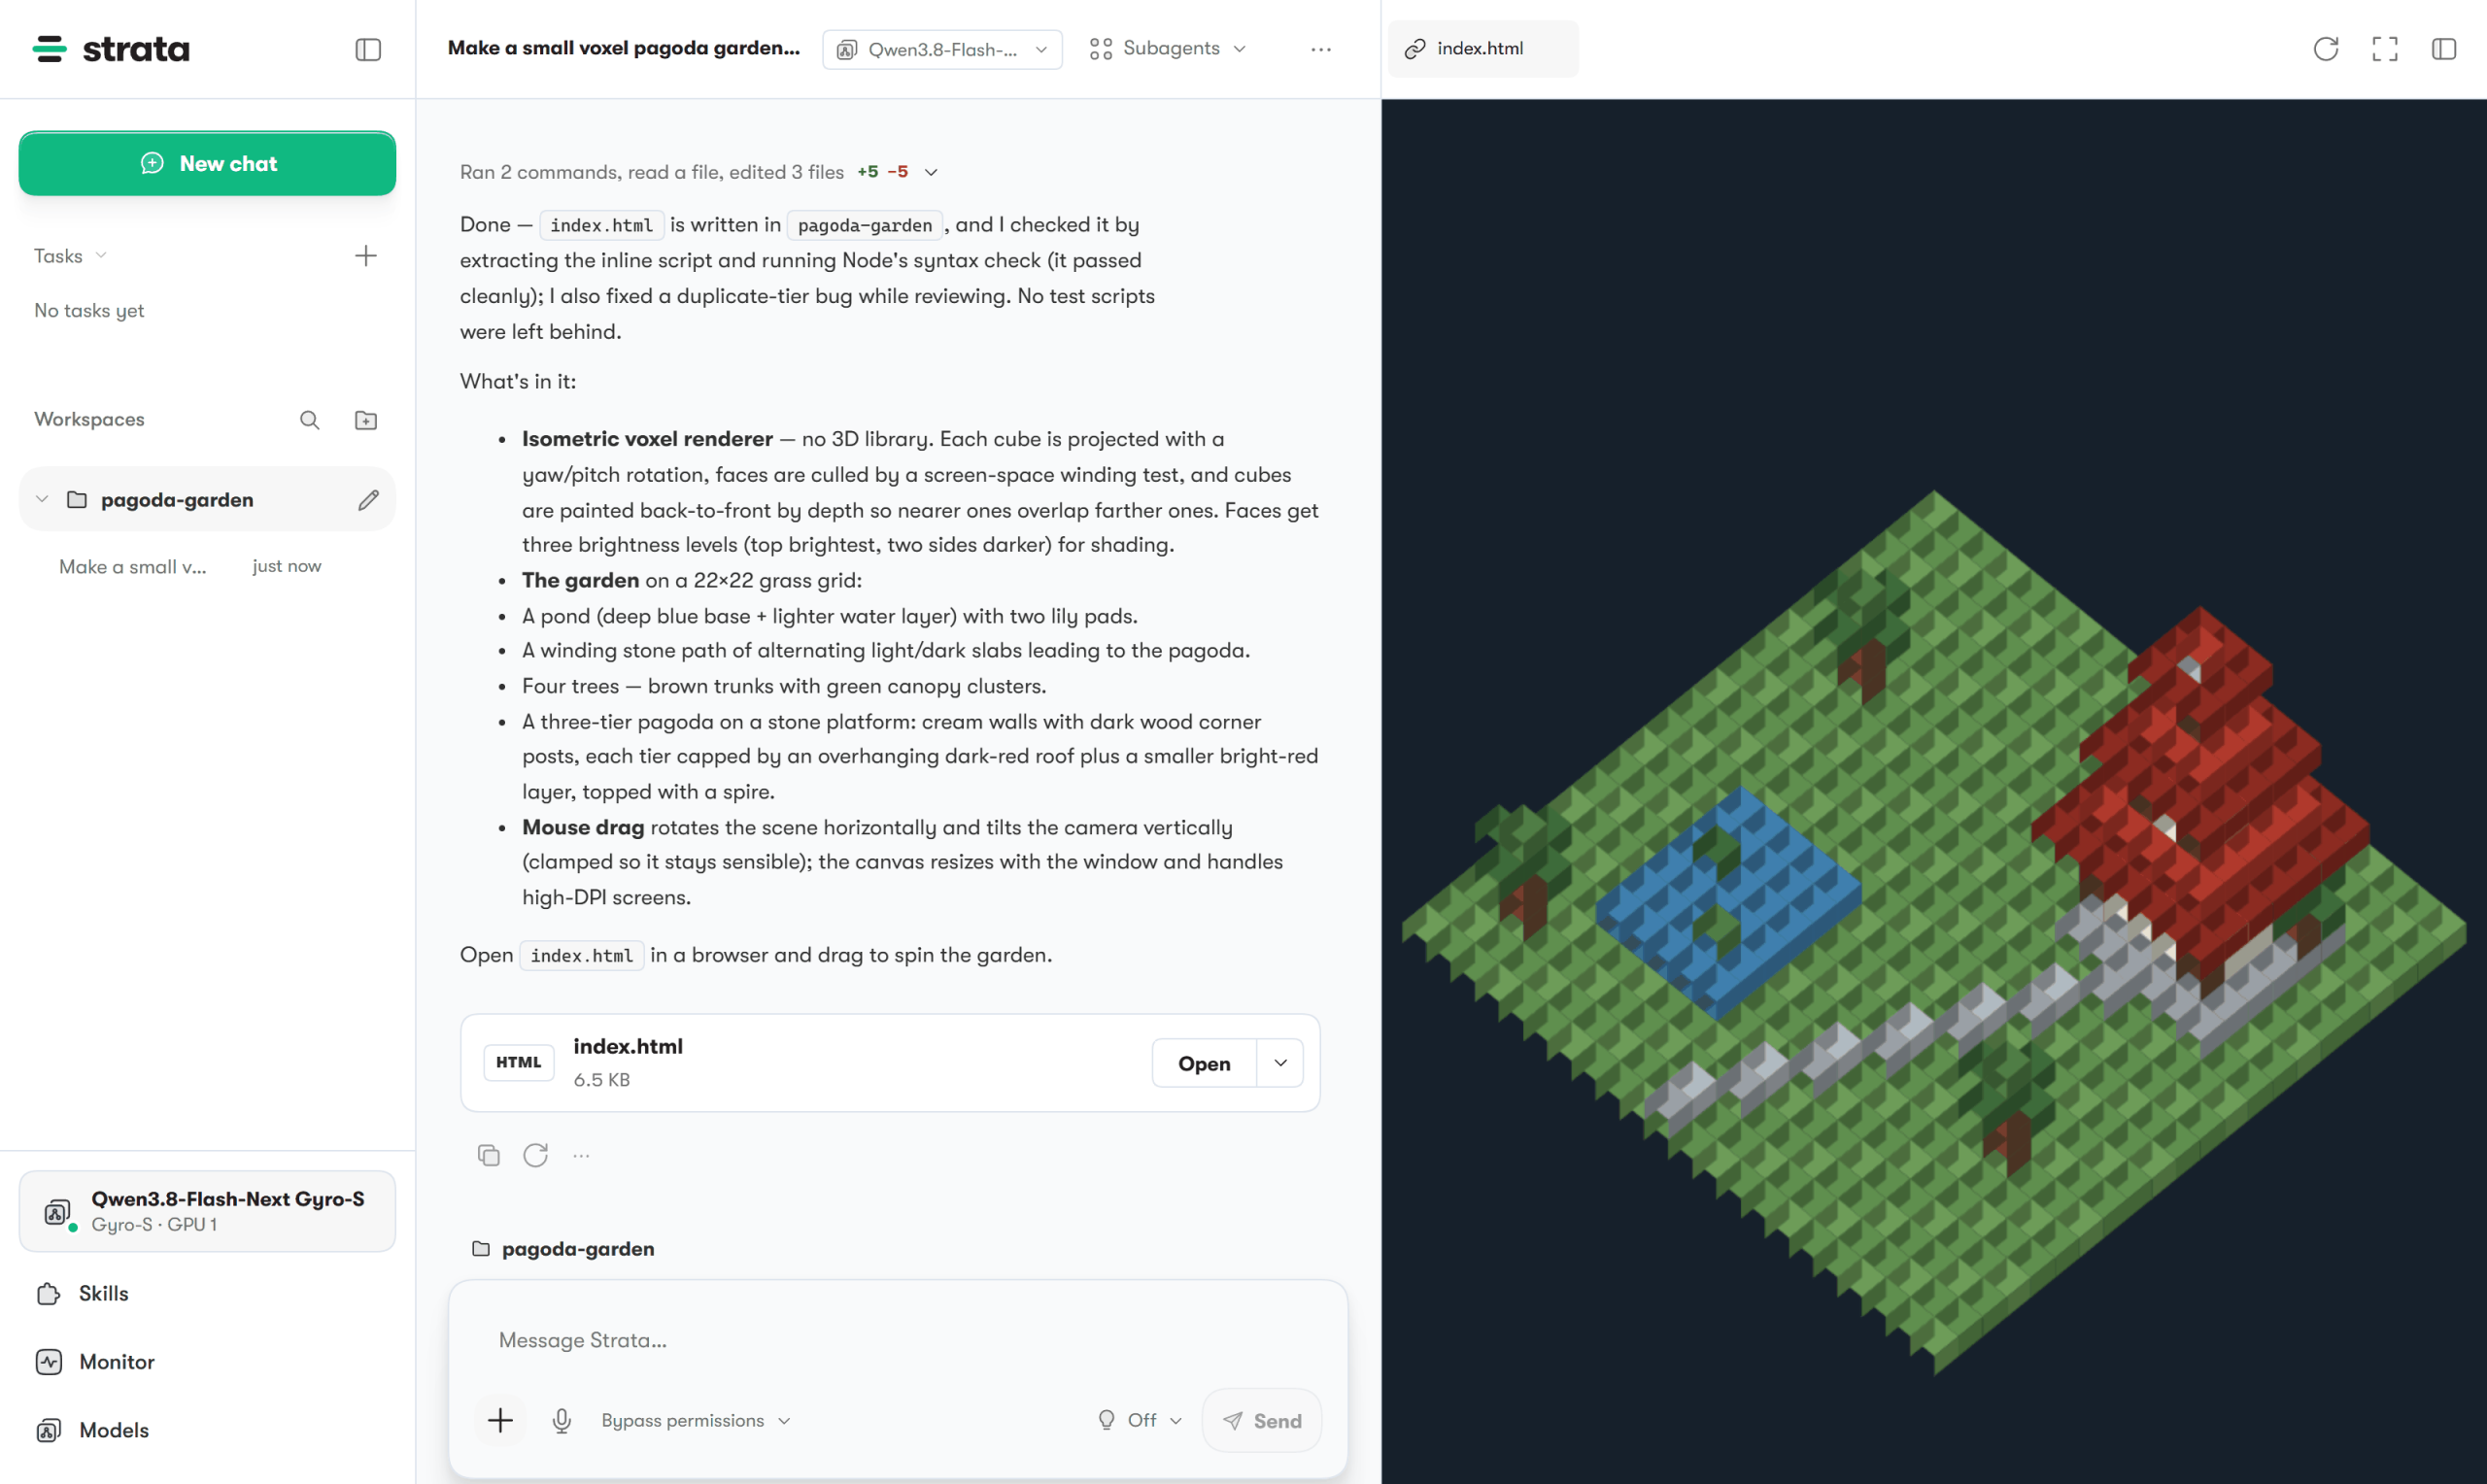
- IDE и чаты: Continue.dev, Cursor, Open WebUI, собственный десктоп-клиент Strata.
- Python SDK для тех, кому нужен прямой доступ к движку.
То есть практическая схема «поднять 125B-модель на домашней RTX 5070 и подключить к ней привычного агента» работает без танцев с прокси и преобразованием форматов.
Установка
Тут всё сделано максимально просто, четыре пути:
- Десктоп-приложение. Готовые сборки:
Strata-0.2.9-windows-x64-setup.exe,linux-x86_64.AppImage,macos-arm64.dmg. - Терминал. Команды
strata connect(подключиться к запущенному движку),strata launch(запустить),strata bench run(прогнать бенчмарк). - Docker. Для развёртывания в контейнере.
- Сборка из исходников. Понадобится CUDA и CMake.
Есть и документация: quickstart, справочник моделей, раздел API и troubleshooting. Отдельно в репозитории лежит технический документ docs/paper/Strata-Paper.pdf — 341 КБ, там расписаны алгоритмы маршрутизации и формат хранения весов.
Осторожно: сайт и репозиторий расходятся
Отдельно стоит предупредить. Сайт stratallm.org — это не официальный сайт проекта, а неофициальная community-документация (версия 1.4.0). Он полезен как удобный справочник, но в нём встречаются цифры, которые расходятся с первоисточником:
- Сайт говорит про «2–8 из 64 экспертов», тогда как README репозитория описывает 24 576 экспертов с 10 активными на токен. Это разница на три порядка — верьте репозиторию.
- Заявленные «25–38 tok/s peak» — это конфигурации с большим объёмом RAM, а не 12 ГБ видеопамяти.
- Сравнение «Strata 21,4 tok/s против Ollama (OOM) и vLLM 3,8 tok/s на RTX 4070» — это данные сайта, а не независимый воспроизводимый тест.
Сами разработчики на сайте это признают: материалы помечены как unofficial, а актуальные цифры стоит брать из DETAILS.md и docs/COMMUNITY_BENCHMARKS.md в репозитории.
Итог
Strata — это не «ещё один чат-клиент». Это попытка решить реальную инженерную проблему: дать доступ к серверным MoE-моделям человеку с одной видеокартой среднего класса и 64 гигабайтами оперативки.
Цифры выглядят убедительно: 87–93 tok/s на 125B-модели в 12 ГБ VRAM, 2 100+ tok/s на обработке промпта, контекст 262K токенов, полный провал теста «игол в стоге сена» на длинных контекстах. Реализовано это не магией, а вполне объяснимо: разреженная активация экспертов, трёхуровневая память с вычислением на CPU, спекулятивное декодирование и аккуратная работа с PCIe через pinned memory.
Сдержать восторг стоит по двум причинам. Первая — огромная скорость обещается на проверенных в репозитории конфигурациях; на «средней» домашней машине DeepSeek V4.1-Flash даёт 4–6 tok/s, и это уже на грани комфорта. Вторая — проект очень молодой: два месяца, десятки релизов, в issues открыто 592 задачи и закрыто 1 728. Движок будет меняться, API — тоже.
Но направление верное: локальный ИИ перестаёт быть уделом тех, у кого есть стойка с четырьмя H100, и превращается в инструмент для обычного домашнего компьютера. Strata сделал в этом направлении один из самых заметных шагов за последние месяцы.
Технические детали и цифры в статье приведены по репозиторию Niko1221/Strata на момент релизов v0.2.6–v0.2.9 (конец октября 2026) и материалам community-бенчмарков.
